
- 产品与解决方案
- 行业解决方案
- 服务
- 支持
- 合作伙伴
- 关于我们
-
-
< 返回
-
行业解决方案
热门推荐
-
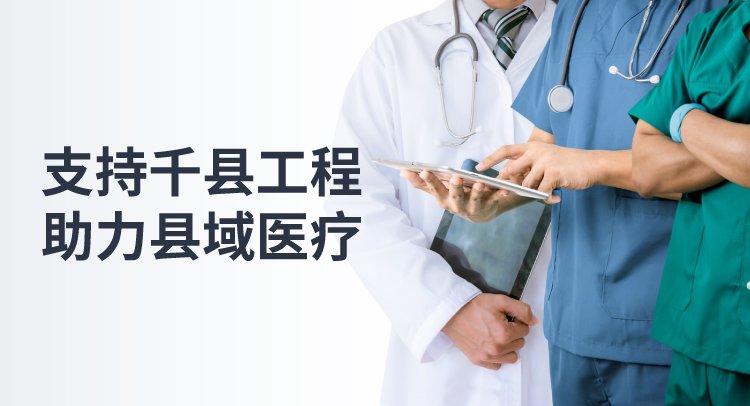
- 从县域医院数字化转型需求出发,新华三推出与实际应用场景紧密结合的智慧医院解决方案,提升县医院综合能力,助力县域内医疗资源整合共享。
-
- 最新最全的营销资料,千份营销资料,快速获取!
-
-
-
-
< 返回
-
技术服务解决方案
热门推荐
-

- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
架构咨询
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
H3C TaaS服务
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
统一运维
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
数据中心
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
云与智能服务
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
安全服务与运营
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
技术维护服务
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
云软件技术支持服务
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
智能终端服务
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
商用终端服务
(台式机 笔记本 显示器)热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
-
-
< 返回
-
技术培训与认证
热门推荐
-
-
-
< 返回
- 如何购买
- 案例中心New
- 数字化领航直播间
- 云上展厅
- 新华三商城






痛点与诉求
1.单一单位算力规模有限,遇到大模型预训练等突发性高算力需求时"一卡难求";
2.同时部分单位算力长期闲置,投资回报低;
3.各自为政的重复建设带来巨大的资金与能耗浪费。
方案总体设计
图灵Token工厂算力联合运营以"管理中心站点 + 各成员站点"两级架构实现多站点并网:
管理中心站点负责全局资源视图与统一调度,各成员站点(厂区、数据中心或第三方算力节点)将本地 GPU 资源接入,图灵Token工厂实时刷新各站点的资源总量、分配量、空闲量及各业务单元 Token 调用量,统一管理中心与成员站点的算力资源与模型服务,可根据需要提供全量服务或部分服务。异构算力经统一池化后,对外提供标准的、无差别的服务接口——上层应用无需感知算力来自何方,实现"算力提供者与 API 调用消费者"的解耦。联合体内部遵循"供应商不锁死"原则:无论模型与智能体来自哪个厂家,只要符合接口规范即可直接调用底层算力。
运营机制
为算力联合提供完整的运营支撑:
动态调度:资源健康度与水位动态维护,调度按节点性能与网络条件择优分配,突发高峰自动将任务溢出到空闲节点,保障业务性能;
高可用保障:跨节点冗余与无感切换保障业务连续性,一个站点故障时任务自动迁移;
对等结算:Token消耗按部门、用户、账户、模型、应用多维计量,为联合体内部的资源对等结算提供数据依据;
安全隔离:通过统一权限与租户隔离机制,各成员单位数据互不可见、资源配额清晰可管。
业务价值
统一纳管:将分散算力汇聚为统一算力池,降低运维复杂度;
投资优化:成员间按需互补,减少重复建设,让每一块GPU都持续产出价值,避免“一边闲置、一边排队”;
能力共享:大模型资产、镜像与应用统一呈现,国产算力与先进算力协同发挥各自优势;
风险分散:跨地域、跨站点的架构显著提升整体可用性与抗风险能力,为大规模智算基础设施建设提供了可复制的样板。
关键技术
1. 多站点并网与全局统一调度
平台以两级架构实现算力资源跨站点实时汇聚:成员站点本地纳管异构 GPU 资源并上报资源总量、分配与空闲状态,管理中心统一维护全局资源水位与健康度,按需将训练、推理任务调度至最优站点。站点间通过确定性网络或专线互联,结合跨站点负载感知实现任务溢出与容灾切换,构建"一个平台、多方算力"的联合运营技术底座。
2. 异构算力统一纳管与标准化输出
底层硬件抽象层全面兼容 X86/ARM 双指令集,跨品牌纳管多元算力;通过驱动框架与全局池化,将不同厂商、不同代际的显卡转化为统一可控的资源池,并以"16 Core/48G/2 Cards"等标准算力规格套餐向用户侧屏蔽复杂逻辑。联合体内各站点即使硬件型号各异,也能以同一套规格、同一套接口对外交付,为对等联合奠定"资产标准化"基础。
3. 标准 OpenAPI 与 MAAS 网关
平台以统一 OpenAPI 充当"技术翻译官",提供与 OpenAI 兼容的行业标准接口,上层智能体与 AI 应用(Openclaw、Dify、RAGFlow 等)可通过标准协议无感调用联合体内任意站点的算力,兼容 NVIDIA RAG Blueprint 等生态最佳实践。模型服务经统一网关认证、寻址与路由,网关根据算力资源实时健康度将请求转发至最合适的工作节点,实现跨站点的"透明化"调用——开发者感知不到算力物理位置的变化。
4. 智能路由与异构协同
针对国产 GPU"长短板"特性,负载感知路由、性能优化路由与 PD 分离路由协同工作:短文本请求路由至显存带宽较低的节点、长上下文请求路由至高性能节点,实现"异构算力,同等体验";PD 分离通过 KV Cache 共享提升显存利用率,是提升单机 QPS 的必由之路。模型资产经标准化封装后可在不同硬件间平滑迁移,一次开发、多处部署,大幅降低联合体内算力替换与协同的成本。
5. 安全与对等结算
联合体多租户场景下,平台提供 API Key 认证、IP 访问控制、双因子认证、敏感词库与调用安全审计等立体防护;Token 消耗按用户、API Key、模型、时间四维下钻统计并实时聚合,为成员间对等结算与容量规划提供可信数据底座;结合弹性扩缩容与低谷缩容策略,联合体内算力始终运行在最优水位。


联系我们获得技术资料和试用版本
联系邮箱:turingsales@h3c.com


