
- 产品与解决方案
- 行业解决方案
- 服务
- 支持
- 合作伙伴
- 关于我们
-
-
< 返回
-
行业解决方案
热门推荐
-
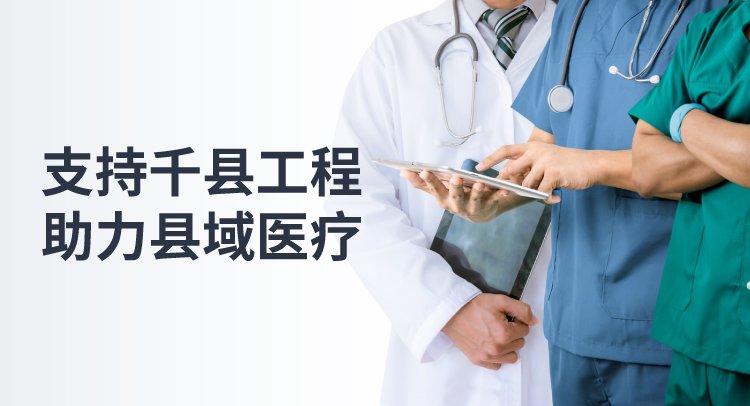
- 从县域医院数字化转型需求出发,新华三推出与实际应用场景紧密结合的智慧医院解决方案,提升县医院综合能力,助力县域内医疗资源整合共享。
-
- 最新最全的营销资料,千份营销资料,快速获取!
-
-
-
-
< 返回
-
技术服务解决方案
热门推荐
-

- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
架构咨询
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
H3C TaaS服务
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
统一运维
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
数据中心
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
云与智能服务
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
安全服务与运营
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
技术维护服务
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
云软件技术支持服务
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
智能终端服务
热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
商用终端服务
(台式机 笔记本 显示器)热门推荐
-
- 面向ICT基础设施提供的一款采用通道封闭,包含工程预制的机柜、配电、制冷、监控等功能单元的独立的小型数据中心,为客户提供数据中心整体产品及交付,全面提升客户IT服务管理水平。
-
-
-
-
< 返回
-
技术培训与认证
热门推荐
-
-
-
< 返回
- 如何购买
- 案例中心New
- 数字化领航直播间
- 云上展厅
- 新华三商城






痛点与诉求
传统智算中心普遍面临重资产投入、回报周期长的困境,“GPU只是成本中心,资产重、价值难以量化”正是其典型痛点。随着大模型应用爆发,市场对算力服务、模型服务的需求日益旺盛,但供给方普遍缺乏成熟的算力经营手段:算力如何定价、如何计量、如何交付、如何运营客户,均缺乏平台化支撑。
对外算力经营模式能够将算力从“资产”转化为“商品”,推动智算中心从重资产设施升级为可自主盈利的经营实体。
方案总体设计
以图灵Token工厂为经营底座,构建"算力池化→模型资产化→服务 API 化→运营商品化"的完整链路。对外提供三类标准化商品:
1.GPU算力商品:将GPU资源封装为“1G显存/10%算力虚拟GPU”、“8卡512G算力节点”“16 Core/48G/2 Cards”等标准规格套餐,通过算力市场上下架、按使用时长计量计费(如“算力币/小时”透明计价);
2.模型服务商品:模型经三步上架至模型服务目录(即“模型超市”),客户点击“立即购买”即可获得API密钥,以OpenAI通用接口格式按Token用量计量,支持按模型、按账户精细统计调用曲线;
3.AI应用商品:通过应用商城为客户提供体验入口,统计使用次数并支持订阅模式。
平台同时提供对外的自助服务门户:用户控制台可查询自己的任务、作业与用量账单;充值商户、短信、人脸识别认证等对外对接能力保障了交易与身份闭环。
运营机制
以"多维运维运营监控"支撑算力经营
多维分析:实时聚合调用次数与Token消耗,支持用户、API Key、模型、时间范围多维下钻分析,精准识别业务高峰与资源消耗大户;
辅助决策:模型消耗Top榜、用户消耗Top榜辅助算力资源分配与客户运营;
分层经营:运营看板提供数据概览,角色权限与渠道商管理支持分层分级的经营体系;
服务保障:客户配额、预算与流量管控能力,既保护平台资源又保障服务SLA。
业务价值
对外算力经营模式为算力运营方带来三重价值:
收入变现:将闲置算力与模型能力直接转化为可计费、可结算的经营收入,实现从“成本中心”到“效益中心”的跨越;
资产增值:通过精细化切分、弹性调度与低谷复用,最大化硬件投资回报率(ROI),“不加硬件提升算力”的存量挖掘持续放大资产价值;
生态聚合:以开放标准API与生态协议吸引开发伙伴、应用伙伴与渠道伙伴入驻,合作AI应用可上架应用商城分成运营,形成“算力+模型+应用”的完整商业生态,共同做大算力经营规模。
关键技术
1. 多维度计量计费引擎
平台构建统一的用量计量体系:GPU 容器按规格与时长计量,模型服务按 Token 消耗计量,Token 调用量支持按密钥、模型、账户、时间段筛选统计,管理端可查看总调用量、TOP 活跃模型、TOP 活跃账户与调用量走势。数据实时聚合、四维下钻,既支撑"按量付费"的计费核算,也为差异化定价与套餐设计提供数据依据,是算力经营的核心底座。
2. 多租户安全与配额管控
面向外部客户的平台必须具备强隔离与可治理能力:基于 RBAC 的角色访问控制贯穿底层运维到终端应用;API Key 认证与调用管控,支持按业务创建项目组并做配额式管理,为精细化运营奠定基础;IP 访问控制、双因子认证、敏感词库与调用安全审计多级防护,确保外部调用安全合规;模型上下架采用"状态锁"机制,上架后锁定核心配置、须下架方可修改,保障线上服务稳定。
3. 商品化服务管理
算力规格支持设置、修改、删除与上下架,模型服务支持创建模板、镜像导入、GPU 算力绑定与启动命令配置的一站式上架,服务发布至统一模型超市实现能力资产化;客户通过"立即购买"自动生成密钥,开通流程全自动化。后台提供运营数据概览、渠道商管理与角色权限配置,支撑规模化、标准化的对外服务运营。
4. 弹性扩缩容与成本控制
基于 PodAutoScaler 按实时业务负载自动调整推理实例副本数,以 KV Cache 利用率、请求等待数、吞吐量为核心指标每 30 秒检测一次并设容忍度防抖动;流量低谷自动缩容释放算力,高峰自动扩容保障 SLA,在"保障服务质量"与"控制运营成本"之间实现动态平衡。配合多路由策略(负载感知、性能优化、PD 分离)与无感自愈的高可用架构,对外服务可承诺稳定、低延迟的商用体验。
5. 标准化开放接口与生态对接
平台对外提供 OpenAI 兼容标准 API,客户一套代码即可调用本地或云端模型服务;通过 OAuth2 授权码模式对接企业业务系统实现账户同步,支持对接充值商户、短信与身份认证服务,形成"注册-充值-开通-调用-结算"的完整商业闭环;多推理引擎与多模态支持实现"一套代码驱动全模态",广泛适配 Nvidia 与国产 GPU,为算力经营构筑开放、可持续演进的技术生态。


联系我们获得技术资料和试用版本
联系邮箱:turingsales@h3c.com


